Современные веб-приложения уже невозможно представить без надёжной системы хранения данных. База данных — это сердце любого проекта: интернет-магазина, социальной сети, банковского сервиса или корпоративного портала. И чем больше становится проект, тем острее встаёт вопрос: что делать, если единственный сервер с базой данных выйдет из строя? Ответ на этот вопрос — репликация, технология, позволяющая поддерживать несколько копий базы данных в актуальном состоянии и распределять нагрузку между ними.
Как мы уже подробно разбирали в предыдущей статье «Один домен на нескольких серверах: мощь, отказоустойчивость и скрытые подводные камни», мультисерверная архитектура даёт проекту впечатляющие преимущества — высокую доступность, горизонтальную масштабируемость и географическое распределение трафика. Однако там же мы отметили, что синхронизация данных является проблемой номер один для такой инфраструктуры. Репликация баз данных — это и есть тот ключевой инструмент, который превращает разрозненные серверы в единую согласованную систему, способную пережить отказ любого узла без потери информации.
Что такое репликация и зачем она нужна
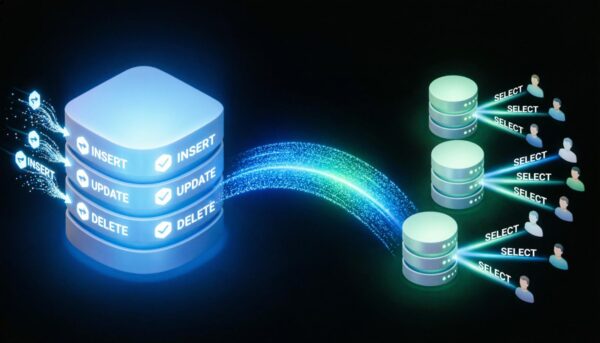
Репликация — это процесс автоматического копирования данных с одного сервера базы данных (называемого мастером или primary) на один или несколько других серверов (реплик или secondary). Каждое изменение, произошедшее на мастере — будь то вставка новой записи, обновление существующей или удаление — передаётся на реплики и применяется там в том же порядке. В результате все узлы системы содержат идентичные или почти идентичные наборы данных.
Зачем это нужно? Причины можно разделить на несколько категорий:
Отказоустойчивость. Если мастер-сервер выходит из строя, одна из реплик может быть повышена до статуса нового мастера, и система продолжит работу с минимальным простоем. Без репликации отказ базы данных означал бы полную остановку проекта до восстановления из резервной копии — процесс, который может занять часы.
Масштабирование чтения. В большинстве веб-приложений количество операций чтения значительно превышает количество операций записи — иногда в десятки раз. Реплики позволяют распределить читающие запросы между несколькими серверами, снимая нагрузку с мастера. Например, каталог товаров, статьи блога и профили пользователей могут читаться с реплик, в то время как оформление заказов и регистрация — обрабатываться мастером.
Аналитика и отчётность. Тяжёлые аналитические запросы, которые могут блокировать таблицы на минуты, лучше выполнять на отдельной реплике, чтобы не замедлять работу основного приложения. Это особенно актуально для проектов с большими объёмами данных.
Географическая близость. Размещая реплики в разных регионах, можно обеспечить пользователям быстрый доступ к данным независимо от их местоположения — тот же принцип, что и в мультисерверной архитектуре, но на уровне базы данных.
Резервное копирование без остановки. Создание бэкапов с реплики не влияет на производительность мастера и не требует остановки сервиса.
Основные модели репликации
Существует несколько архитектурных подходов к репликации, и выбор между ними определяет поведение системы в критических ситуациях.
Master-Slave (Primary-Replica)
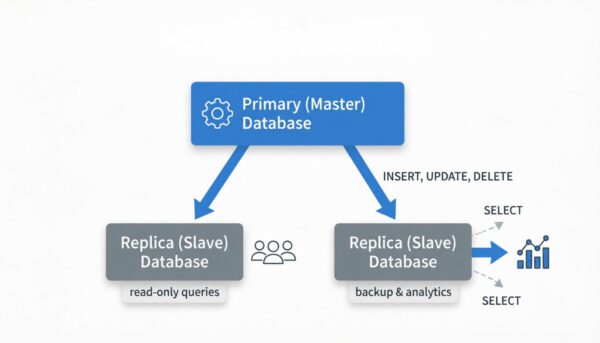
Классическая и наиболее распространённая модель. Один сервер является мастером и принимает все операции записи. Один или несколько слейвов получают изменения от мастера и обслуживают только чтение. Это простое, предсказуемое и надёжное решение, которое используется в подавляющем большинстве проектов.
Главный недостаток — мастер остаётся единой точкой отказа для записи. Если он падает, нужно вручную или автоматически повысить одну из реплик, что требует времени и может привести к потере последних транзакций, если они не успели реплицироваться.
Master-Master (Multi-Primary)
В этой модели запись возможна на любой из узлов, и каждый узел реплицирует свои изменения на остальные. Это обеспечивает высокую доступность записи, но порождает серьёзную проблему — конфликты. Если два сервера одновременно изменят одну и ту же запись, возникнет конфликт, который нужно разрешать по определённым правилам (например, по временной метке или по приоритету узла). Разрешение конфликтов — сложная тема, и ошибки в ней могут привести к повреждению данных.
Master-master чаще используется в географически распределённых системах, где задержка репликации между континентами слишком велика для комфортной работы с одним мастером.
Каскадная репликация
Промежуточный вариант, при котором реплики получают данные не напрямую от мастера, а от других реплик. Это снижает нагрузку на мастер и позволяет строить иерархические топологии. Например, мастер реплицирует данные на один сервер в Европе, а тот, в свою очередь, — на несколько серверов внутри региона.
Синхронная и асинхронная репликация
Асинхронная репликация — мастер подтверждает транзакцию клиенту, не дожидаясь, пока её применят реплики. Это быстро, но существует риск потери данных при отказе мастера: транзакция могла быть подтверждена, но не успеть дойти до реплик.
Синхронная репликация — мастер ждёт подтверждения от хотя бы одной реплики перед тем, как сообщить клиенту об успехе. Это гарантирует сохранность данных, но увеличивает время отклика и снижает доступность: если реплика недоступна, запись блокируется.
Полусинхронная репликация — компромиссный вариант, при котором мастер ждёт подтверждения от реплики с таймаутом. Если реплика не отвечает вовремя, мастер переключается в асинхронный режим и продолжает работу. Этот подход используется в MySQL (semi-sync replication) и позволяет балансировать между надёжностью и производительностью.
Механизмы репликации в популярных СУБД
MySQL и MariaDB
Классическая репликация основана на бинарном логе (binlog): мастер записывает все изменения в лог, а реплики читают его и применяют. Существует два формата binlog: statement-based (записываются сами SQL-запросы) и row-based (записываются изменённые строки). Row-based считается более надёжным, так как исключает недетерминированные запросы вроде NOW() или RAND().
Для современных требований всё чаще используется Group Replication — встроенное решение MySQL 5.7+, обеспечивающее синхронную репликацию с автоматическим разрешением конфликтов и автоматическим failover. На его основе построен MySQL InnoDB Cluster — полноценное кластерное решение с управлением через MySQL Shell.
Galera Cluster — стороннее решение для MySQL/MariaDB, обеспечивающее синхронную мультимастерную репликацию. Все узлы кластера равноправны, запись возможна на любой из них, а данные гарантированно согласованы. Galera широко применяется в проектах, где требуется высокая доступность записи.
PostgreSQL
PostgreSQL поддерживает потоковую репликацию (streaming replication) на основе WAL (Write-Ahead Log). Мастер непрерывно передаёт записи WAL на реплики, которые применяют их к своим данным. Начиная с версии 9.0, доступна горячая реплика (hot standby), позволяющая выполнять запросы на чтение с реплик.
Для автоматического failover в PostgreSQL-экосистеме используются инструменты вроде Patroni, repmgr или Stolon. Patroni, пожалуй, самый популярный выбор: он управляет кластером через распределённое хранилище (etcd, Consul, ZooKeeper), автоматически повышает реплику при отказе мастера и следит за состоянием всех узлов.
Логическая репликация — более гибкий механизм, позволяющий реплицировать отдельные таблицы или даже отдельные строки, а также выполнять преобразования данных на лету. Она полезна для миграции между версиями PostgreSQL, консолидации данных из нескольких источников и построения аналитических хранилищ.
MongoDB
MongoDB использует репликасеты — группы узлов, где один является первичным (primary), а остальные — вторичными (secondary). Все записи идут через primary, а secondary-узлы реплицируют oplog (журнал операций) и могут обслуживать чтение при соответствующей настройке read preference. При отказе primary узлы автоматически выбирают нового лидера через механизм выборов (election). Репликасеты — фундаментальная часть MongoDB, и даже в минимальной конфигурации рекомендуется использовать как минимум три узла.
Проблемы и подводные камни
Репликация — не серебряная пуля, и у неё есть свои сложности, которые необходимо учитывать при проектировании.
Задержка репликации (Replication Lag)
Асинхронная репликация неизбежно приводит к задержке: реплика отстаёт от мастера на некоторое время — от миллисекунд до минут при высокой нагрузке. Это порождает классическую проблему: пользователь оформил заказ, система записала его в мастер, но при следующем запросе на чтение с реплики заказ «не найден», потому что данные ещё не успели туда добраться. Решение — либо читать критичные данные с мастера, либо использовать стратегию «read-your-writes», при которой пользователь читает с того же узла, куда писал.
Конфликты при мультимастерной репликации
Как уже упоминалось, одновременная запись на несколько мастеров может привести к конфликтам. Разрешение конфликтов — сложная задача, и в некоторых случаях она приводит к необратимым потерям данных. Поэтому мультимастерные схемы применяются с осторожностью и только там, где это действительно необходимо.
Failover и split-brain
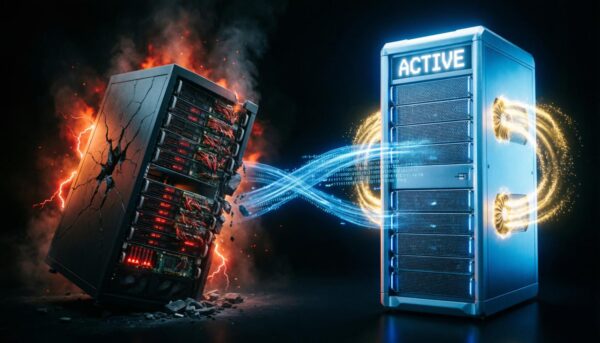
При отказе мастера нужно повысить одну из реплик. Если автоматика сработает неправильно или сеть разделится на две изолированные части (split-brain), может возникнуть ситуация, когда два узла одновременно считают себя мастером и принимают конфликтующие записи. Это одна из самых опасных ситуаций в распределённых системах, и для её предотвращения используются кворумные механизмы (например, через etcd или ZooKeeper), требующие согласия большинства узлов для принятия решений.
Мониторинг состояния реплик
Критически важно отслеживать, насколько каждая реплика отстаёт от мастера. Инструменты вроде SHOW SLAVE STATUS в MySQL или pg_stat_replication в PostgreSQL дают эту информацию. Без мониторинга можно однажды обнаружить, что реплика отстала на несколько часов, и при аварийном переключении пользователи потеряют часть данных.
Заключение
Репликация баз данных — это фундаментальная технология, без которой невозможно построить по-настоящему надёжную и масштабируемую веб-инфраструктуру. Она решает задачи отказоустойчивости, распределения нагрузки, географической оптимизации и резервного копирования, превращая хрупкую систему из одного сервера в устойчивый распределённый организм.
Однако, как и любая мощная технология, репликация требует глубокого понимания: выбора правильной модели (master-slave или master-master), режима (синхронный или асинхронный), инструментов управления failover и постоянного мониторинга состояния системы. Ошибки в настройке репликации могут привести к потере данных, конфликтам и неожиданным простоям, поэтому к проектированию этой части инфраструктуры стоит подходить с максимальной серьёзностью.
Если ваш проект растёт и один сервер базы данных перестаёт справляться с нагрузкой, а простой в несколько минут обходится слишком дорого — репликация станет следующим логичным шагом в развитии инфраструктуры. Главное — не торопиться, выбрать подходящий инструмент под конкретную СУБД и тщательно протестировать поведение системы в сценариях отказа. Тогда данные будут надёжно жить в нескольких местах одновременно, а ваш сервис — работать бесперебойно в любых условиях.